Vertrauensmodell
Jede Zahl hat eine Adresse.
Eine Zahl ohne Adresse erreicht den Bildschirm nicht. Das Vertrauensmodell verlässt sich nicht auf Prompting, und es geht nicht davon aus, dass Fehler abnehmen, wenn Modelle besser werden. Es verlässt sich auf eine deterministische Kontrollkette zwischen der Zahl und dem Satz — und darauf, festzuhalten, was diese Kette abgelehnt hat.
Nachvollziehbarkeit
Läuft eine Abfrage, wird ihr Ergebnis in einen Umschlag versiegelt. Jeder Wert darin erhält eine Adresse.
Welcher Umschlag, welche Zeile, welche Zelle — und am Ende eine Prüfziffer, damit nicht versehentlich die falsche Tür geöffnet wird. Nutzt der Agent eine Zahl, gibt er diese Adresse an. Die Engine schlägt sie nach und vergleicht. Selbst ein Prozentwert wird nie dem Modell überlassen: Es kann nicht „dividiere“ sagen, es fragt die Engine nach dem Verhältnis.
Vier Schritte, in dieser Reihenfolge, jedes Mal
- Die angegebene Adresse wird zerlegt — Umschlag, Zeile, Zelle.
- Die Prüfziffer wird verifiziert. Schlägt sie fehl, wird gar nicht erst aufgelöst.
- Der Umschlag wird geöffnet und der tatsächliche Wert in der Zelle gelesen.
- Die Zahl, die der Agent geschrieben hat, und der gelesene Wert werden verglichen.
Die Adresse reicht bis zum Abfrageschritt — welche Abfrage, welcher Zeitraum, welche Filter — nicht bis zur einzelnen Warehouse-Zeile. Wir schreiben das lieber hier hin, als dass Sie es in Woche drei eines Piloten entdecken.
Trust-Stufen
A freigegebene offizielle Kennzahl · B abgeleitet · C explorativ oder Kandidat. Ein Wert der Stufe C kann nicht roh in einen Brief gelangen, und die Hochstufung auf A ist eine menschliche Entscheidung.
Ein einzelnes Abzeichen mit einem „Konfidenzwert“ gibt es bewusst nicht.
FinalGuard
Das letzte Gate vor der Auslieferung. Keine KI. Nicht abschaltbar.
Null Toleranz: Ein Cent daneben wird abgelehnt, und eine Antwort, die vor dem Lauf einer Abfrage geschrieben wurde, wird abgelehnt, selbst wenn die Zahl zufällig stimmt.
Die Ablehnungsleiter
- Erste Ablehnung → die Antwort wird zurückgehalten; dem Agenten wird gesagt, die Werte aus dem Umschlag wortgetreu zu verwenden.
- Zweite Ablehnung → gibt es genau einen eindeutigen Umschlag, schreibt die Engine die Antwort selbst.
- Dritte Ablehnung → ehrlicher Abbruch.
Einbehaltene Werte
Eine Zahl ohne Nachweis wird aus dem Text entfernt und mit ihrer Begründung in einem Kasten unter der Antwort protokolliert. Sie ist strukturell von Export, Weitergabe und Gedächtnis ausgeschlossen. Wurde eine Korrektur vorgenommen, erscheint unter der Antwort ein Hinweis — nie versteckt.
Gemessen. Über unsere eigene Betriebsaufzeichnung hinweg hat die Herkunftsprüfung 282 Antwortentwürfe über 275 Läufe gestoppt; der Agent korrigierte 87,2 % im nächsten Versuch. Die Prüfseite, die diese Zahl führt, weigert sich, eine Trendlinie hindurchzulegen: Eine steigende Ablehnungsquote bedeutet nicht, dass die Agenten schlechter geworden sind.
Eine bewusste Leerstelle. Es gibt kein Abzeichen „Geprüft ✓“. Gekennzeichnet wird nur das Unprüfbare, damit eine zufällige Übereinstimmung nie einen falschen Stempel verdient.
Was die Gates abgelehnt haben
Mitten im Lauf schickte die Engine einen ganzen Antwortentwurf zurück.
Jeder Anbieter kann Ihnen ein gutes Briefing zeigen. Verlangen Sie zu sehen, was das System zu sagen verweigert hat.
Das ist ein einzelner geplanter Lauf, vollständig geöffnet. Er begann um 05:00 Uhr, war 285 Sekunden später fertig und kostete 78 Cent Modellausgaben, eingefroren zum an diesem Tag geltenden Preis. Dreizehn Kandidaten erreichten die Datenbank. Zwei überstanden die Gates nicht, und ihre Gründe liegen weiterhin vor.
Seine Zahlen hatten keine Adresse, die die Engine auflösen konnte. Das hat sie geschrieben.
[engine] Structural rule (numeric provenance): every figure in a final answer
is exactly one of three things. ADDRESSED (declared in the claims block with
the ref you read it from), COMPUTED (declared with op and operands that are
addresses), or STRUCTURE the engine or the user put there. Nothing else is
proven. A value that merely EXISTS somewhere in the evidence is not proven
until you name its address.
Ihre Antwort wurde NICHT ausgeliefert.
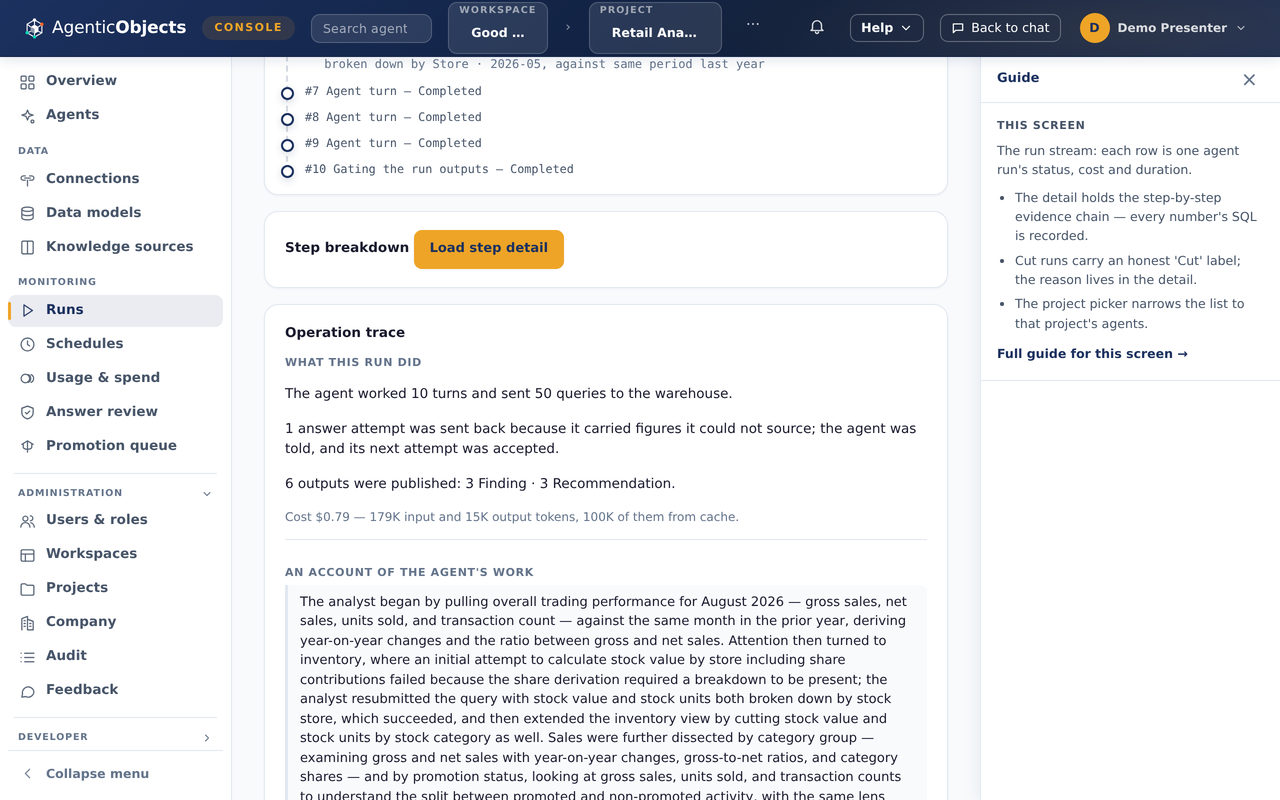
Über die gesamte Betriebsaufzeichnung wurden elf Kandidatenobjekte zurückgehalten. Neun gehörten zur selben Familie: am schnellsten wachsend, am schwächsten, am höchsten. Die Satzart, die das Gate am häufigsten abfängt, ist genau die Satzart, nach der eine Führungskraft am ehesten handelt.
Im Produkt
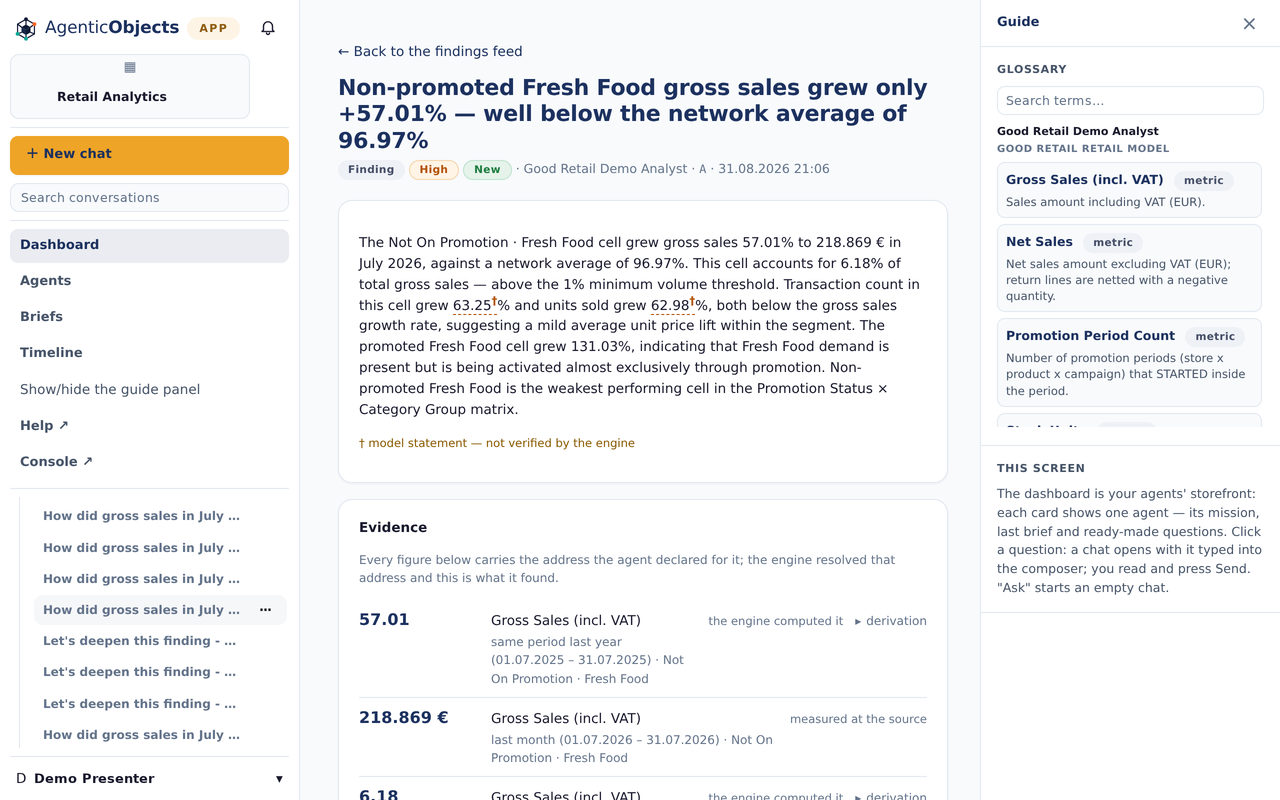
Das Nachweisfeld, im Auslieferungszustand
Jede Zahl trägt die Adresse, die der Agent für sie angegeben hat, und das, was die Engine beim Auflösen dieser Adresse vorgefunden hat.

Vier Fragen
Unternehmensvertrauen ruht auf vier Fragen. Keine davon bleibt der KI überlassen — und jede Antwort nennt ihre Grenze.
Nachvollziehbarkeit — „Woher kam diese Zahl?“
Jede Zahl trägt eine dreiteilige Adresse: Umschlag, Zeile, Zelle. Die Engine vergibt sie; der Agent gibt sie nur an. Jede Aufzeichnung ist mit dem Lauf, dem Agenten, dem eingefrorenen Modell und der Benutzerberechtigung verknüpft, die sie erzeugt haben. Werte werden bei der Erzeugung auf die Aufzeichnung eingefroren, sodass der Nachweis auch dann bestehen bleibt, wenn das Lauf-Log bereinigt wird.
Die Adresse reicht bis zum Abfrageschritt — welche Abfrage, welcher Zeitraum, welche Filter — nicht bis zur einzelnen Warehouse-Zeile.
Prüfbarkeit — „Wer, wann, womit, zu welchen Kosten?“
Das Audit-Log ist append-only. Keine Aufzeichnung wird gelöscht, nur archiviert; Bewertungen werden überstempelt. Die Publikationskette ist deterministisch: gleiche Eingabe, gleiches Ergebnis. Jeder verworfene, zurückgehaltene oder doppelte Kandidat steht mit seiner Begründung im Guard Ledger. Grenzen für Schritte, Zeit und Kosten werden vor jedem Lauf eingefroren.
Das Audit-Log liegt im Produkt. Der Export in ein SIEM oder ein externes Prüfsystem wird im Piloten gesondert abgegrenzt.
Transparenz — „Was hat das System getan, und was nicht?“
Nichts verschwindet stillschweigend. Ein wiederkehrendes Thema wird ongoing / repeat gestempelt und gezählt, nicht versteckt. Ein leerer Zeitraum fällt in eine eigene Klasse data state. Kausale oder superlative Sprache wird als interpretive gekennzeichnet: Gemessenes wird von Gedeutetem getrennt. Im Chat getroffene Annahmen werden ausgeschrieben.
Benachrichtigungstexte tragen bewusst keine Werte. Transparenz liegt in der Aufzeichnung, nicht in der Benachrichtigung.
Erklärbarkeit — „Warum kam es zu diesem Schluss?“
In jedem Finding schreibt die Engine Kennzahl, Zeitraum und Filter. Jede Recommendation öffnet mit einem Klick das Finding, auf dem sie beruht. „Drill down in chat“ nimmt das Finding als zitierte Daten mit in eine Unterhaltung, sodass das „Warum?“ über denselben Nachweis gestellt wird.
Das Produkt erklärt, woher die Zahlen im Satz kamen — nicht, warum das Modell den Satz so formuliert hat. Der Schweregrad ist eine Aussage des Agenten. Der Nachweis wird erklärt; das Urteil bleibt menschlich.

Abwesenheit und Annahme
Das Zweite, das so gefährlich ist wie eine falsche Zahl: eine richtige Zahl, falsch verstanden.
- Annahmen werden vorab genannt. „Sie haben keinen Zeitraum angegeben; das Gesamtjahr 2024 wurde angenommen.“ Ein fester Satzbaustein, jedes Mal gleich.
- Aktualität wird gemessen, nie angenommen. „Dieses Modell enthält Daten bis 31. Dez. 2025 — gemessen, nicht geschätzt.“
- Eine Granularität, die das Modell nicht führt, wird abgelehnt, nicht genähert. „Eine Quartalssicht ist in diesem Modell nicht verfügbar.“ Die Engine baut kein Quartal aus Monaten zusammen, um die Frage zu bedienen.
- Ein eingeschränkter Nutzer sieht seine eigene Einschränkung. „Geltungsbereich: Filiale — Maltepe Park.“ Die Regel lebt in der Engine; ohne auflösbare Identität hält sie an, statt auf „alles anzeigen“ zurückzufallen.
- Personenbezogene Daten werden maschinell maskiert. Eine Aufschlüsselungsbezeichnung wird per Regel auf Initialen verkürzt, nicht per Prompt.
- Abwesenheit wird veröffentlicht, nicht verschluckt. Ein Zeitraum ohne Daten wird zu einem data state mit der Grundlage
empty_result_set: „keine gemessene Null; in diesem Fenster sind keine Transaktionen erfasst.“ Kein Schweregrad-Abzeichen, ein eigener Bereich, und keine Recommendation darf darauf beruhen.
Selbstprüfung
„Jede Zahl wird geprüft“ ist eine Behauptung. Also wird sie jede Woche getestet.
Golden Set
Ein versiegelter Fragensatz. Liefern zwei Läufe denselben Fingerabdruck, hat sich das Verhalten nicht geändert. Ändert sich das Modell oder der Code, zeigt sich der Unterschied sofort.
Null-Toleranz-Linie
Zahlen ohne Quelle, die Weigerung zu schätzen, die Maskierung personenbezogener Daten. Auch das Erreichen der Schwelle durch Löschen von Zahlen wird erkannt.
Takt
Die Tests laufen automatisch jede Woche und bei jedem Release-Abschluss. Widerspricht eine Behauptung der Messung, stoppt sich das System selbst.
Ansicht laufender Dienste
Bei jedem Laden gemessen; es zeigt nie einen gespeicherten Status.
Das Vertrauensmodell geht nicht davon aus, dass Fehler abnehmen, wenn Modelle besser werden. Selbst wenn sich das Modell ändert, bleiben Adressierung, Audit-Log, Publikationskette und Berechtigungsprüfungen deterministisch.