Modelo de confianza
Cada cifra tiene una dirección.
Una cifra que no la tiene no puede llegar a la pantalla. El modelo de confianza no depende del prompting, y no da por supuesto que los errores vayan a caer a medida que mejoren los modelos. Depende de una cadena de control determinista entre la cifra y la frase — y de dejar constancia de lo que esa cadena rechazó.
Trazabilidad
Cuando se ejecuta una consulta, su resultado se sella dentro de un sobre. Cada valor que contiene recibe una dirección.
Qué sobre, qué fila, qué celda — y un dígito de control al final, para que no se abra la puerta equivocada por accidente. Cuando el agente usa una cifra, declara esa dirección. El engine la busca y compara. Ni siquiera un porcentaje se deja al modelo: no puede decir “divide”, le pide la razón al engine.
Cuatro pasos, en este orden, siempre
- La dirección declarada se analiza — sobre, fila, celda.
- Se verifica el dígito de control. Si falla, no se intenta siquiera la resolución.
- Se abre el sobre y se lee el valor real de la celda.
- Se compara la cifra que escribió el agente con el valor leído.
La dirección llega hasta el paso de consulta — qué consulta, qué periodo, qué filtros — no hasta la fila concreta del warehouse. Preferimos escribirlo aquí a que usted lo descubra en la tercera semana de un piloto.
Niveles de trust
A métrica oficial aprobada · B derivada · C exploratoria o candidata. Un valor de nivel C no puede entrar en bruto en un brief, y ascenderlo a A es una decisión humana.
Deliberadamente no existe ninguna insignia única de “puntuación de confianza”.
FinalGuard
El último gate antes de la entrega. No es una IA. No se puede desactivar.
Tolerancia cero: un céntimo de desviación se rechaza, y una respuesta escrita antes de que se ejecutara una consulta se rechaza aunque la cifra resulte ser correcta.
La escalera de rechazo
- Primer rechazo → la respuesta se retiene; se le indica al agente que use los valores del sobre tal cual.
- Segundo rechazo → si hay exactamente un sobre claro, el engine escribe la respuesta él mismo.
- Tercer rechazo → corte honesto.
Valores retenidos
Una cifra sin evidencia se retira del cuerpo del texto y se registra en un recuadro bajo la respuesta con su motivo. Queda bloqueada estructuralmente para la exportación, la distribución y la memoria. Si se hizo una corrección, aparece una nota bajo la respuesta — nunca oculta.
Medido. En todo nuestro registro operativo, la comprobación de procedencia detuvo 282 borradores de respuesta a lo largo de 275 ejecuciones; el agente corrigió el 87,2 % en el siguiente intento. La página de revisión que lleva esta cuenta se niega a trazar una línea de tendencia a través de ella: una tasa de rechazo creciente no significa que los agentes hayan empeorado.
Una ausencia deliberada. No existe ninguna insignia de “Verificado ✓”. Solo se marca lo no verificable, de modo que una coincidencia casual nunca se gana un sello falso.
Qué rechazaron los gates
A mitad de ejecución, el engine devolvió un borrador de respuesta entero.
Cualquier proveedor puede enseñarle un buen informe. Pida ver lo que el sistema se negó a decir.
Esta es una única ejecución programada, abierta por completo. Empezó a las 05:00, terminó 285 segundos después, y costó 78 céntimos de gasto de modelo, congelado al precio vigente ese día. Trece registros candidatos llegaron a la base de datos. Dos no sobrevivieron a los gates, y sus motivos siguen archivados.
Sus cifras no tenían ninguna dirección que el engine pudiera resolver. Esto es lo que escribió.
[engine] Structural rule (numeric provenance): every figure in a final answer
is exactly one of three things. ADDRESSED (declared in the claims block with
the ref you read it from), COMPUTED (declared with op and operands that are
addresses), or STRUCTURE the engine or the user put there. Nothing else is
proven. A value that merely EXISTS somewhere in the evidence is not proven
until you name its address.
Su respuesta NO fue entregada.
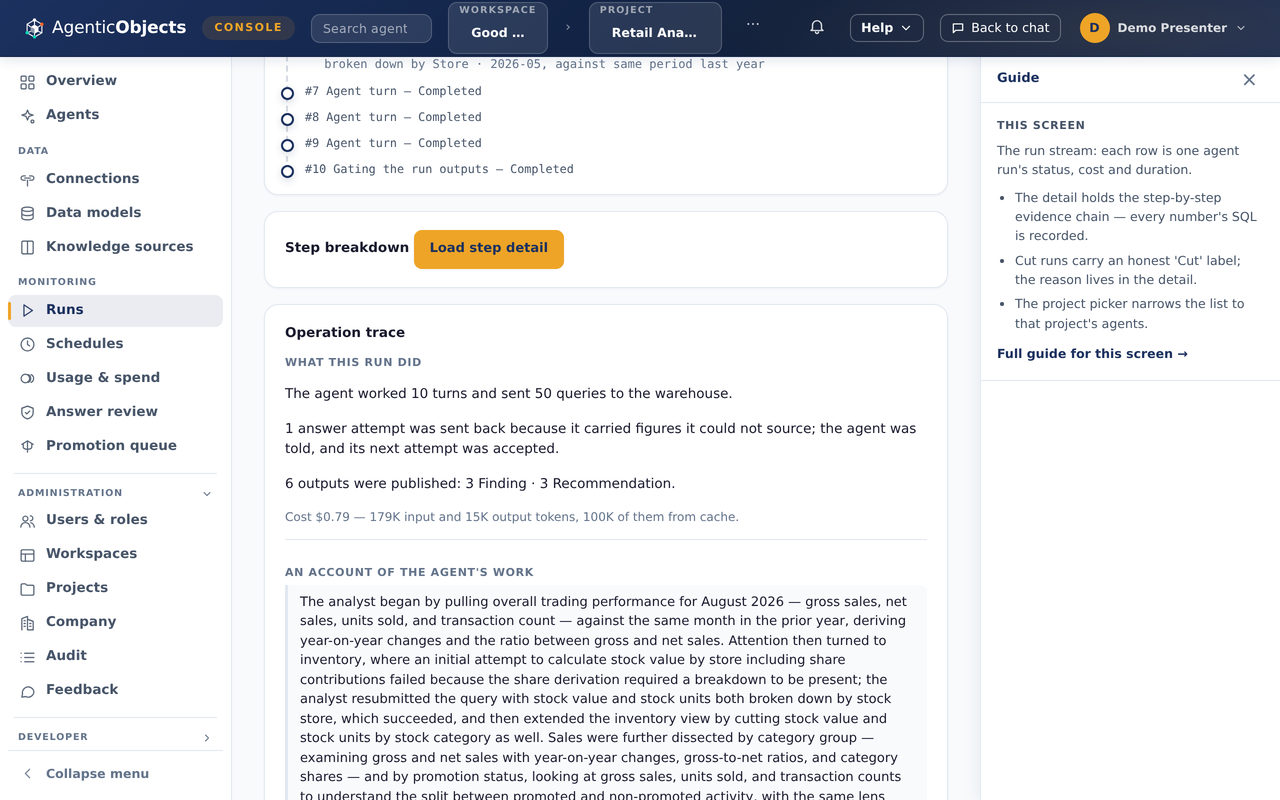
En todo el registro operativo se retuvieron once objetos candidatos. Nueve eran de la misma familia: el de mayor crecimiento, el más débil, el más alto. La clase de frase que el gate detecta con más frecuencia es exactamente la clase sobre la que un directivo tiene más probabilidades de actuar.
En el producto
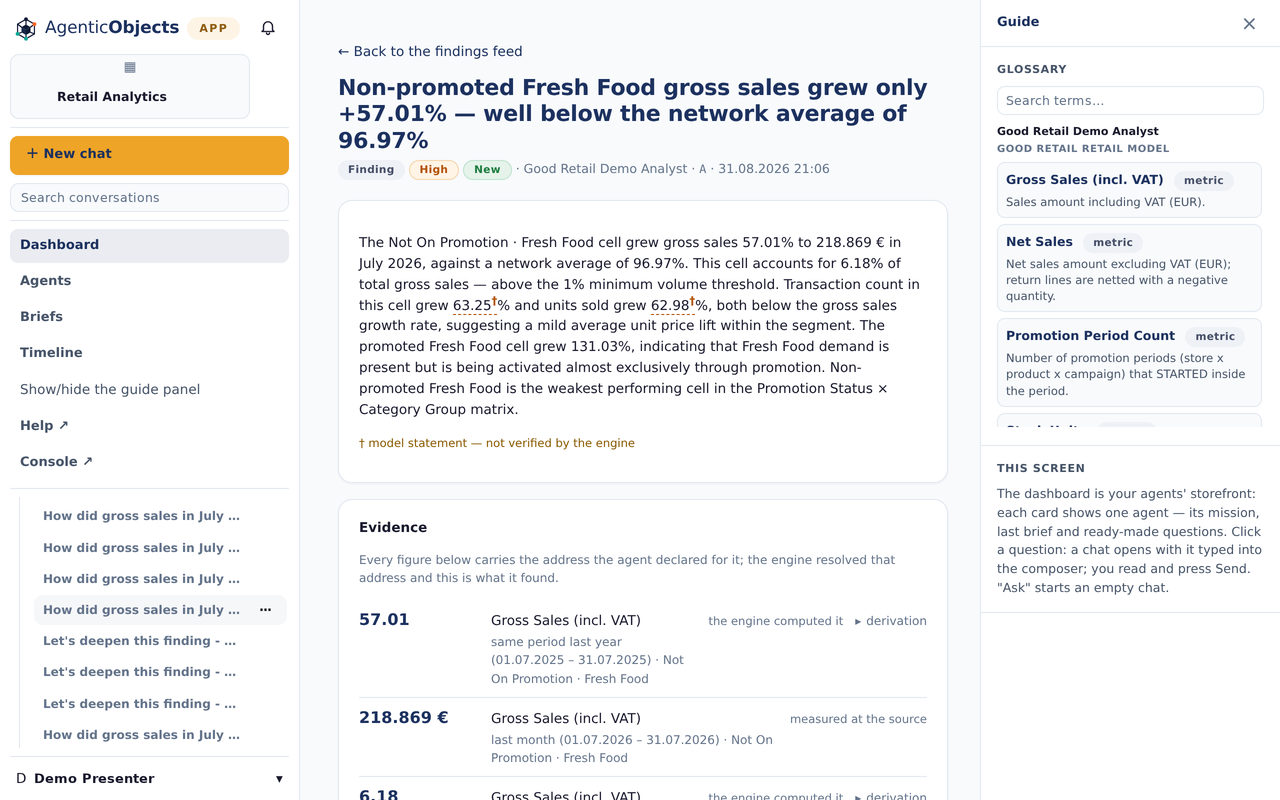
El panel de evidencia, tal como se entrega
Cada cifra lleva la dirección que el agente declaró para ella, y lo que el engine encontró al resolver esa dirección.

Cuatro preguntas
La confianza corporativa descansa sobre cuatro preguntas. Ninguna se deja en manos de la IA — y cada respuesta declara su límite.
Trazabilidad — “¿De dónde salió esta cifra?”
Cada cifra lleva una dirección de tres partes: sobre, fila, celda. La asigna el engine; el agente solo la declara. Cada registro está enlazado a la ejecución, al agente, al modelo congelado y a la autoridad de usuario que lo produjo. Los valores se congelan sobre el registro en el momento de la creación, de modo que la evidencia sobrevive aunque se limpie el log de la ejecución.
La dirección llega hasta el paso de consulta — qué consulta, qué periodo, qué filtros — no hasta la fila concreta del warehouse.
Auditabilidad — “¿Quién, cuándo, con qué, a qué coste?”
El registro de auditoría es de solo anexado. Ningún registro se borra, solo se archiva; los votos se sellan encima. La cadena de publicación es determinista: misma entrada, mismo resultado. Cada candidato descartado, retenido o duplicado figura en el Guard Ledger con su motivo. Los límites de pasos, tiempo y coste se congelan antes de que arranque cada ejecución.
El registro de auditoría vive dentro del producto. La exportación a un SIEM o a un sistema de auditoría externo se acota aparte en el piloto.
Transparencia — “¿Qué hizo el sistema, y qué no hizo?”
Nada desaparece en silencio. Un tema recurrente se sella ongoing / repeat y se cuenta, no se oculta. Un periodo vacío cae en una clase data state aparte. El lenguaje causal o superlativo recibe la insignia interpretive: lo medido se separa de lo interpretado. Los supuestos hechos en el chat se escriben de forma explícita.
Los textos de notificación deliberadamente no llevan valores. La transparencia está dentro del registro, no en la notificación.
Explicabilidad — “¿Por qué llegó a esta conclusión?”
En cada finding, la métrica, el periodo y los filtros los escribe el engine. Cada recommendation abre en un clic el finding en el que se apoya. “Profundizar en el chat” lleva el finding a una conversación como datos citados, de modo que el “¿por qué?” se pregunta sobre la misma evidencia.
El producto explica de dónde salieron las cifras de la frase — no por qué el modelo redactó la frase de esa manera. La gravedad es una afirmación del agente. La evidencia se explica; el juicio sigue siendo humano.

Ausencia y supuesto
Lo segundo tan peligroso como una cifra equivocada: una cifra correcta mal entendida.
- Los supuestos se declaran por adelantado. “No indicó un periodo; se asumió el año completo 2024.” Una frase de plantilla fija, idéntica siempre.
- La frescura se mide, nunca se supone. “Este modelo contiene datos hasta el 31 dic 2025 — medido, no estimado.”
- Un nivel de detalle que el modelo no contiene se rechaza, no se aproxima. “En este modelo no hay vista trimestral disponible.” El engine no construirá un trimestre a partir de meses para satisfacer la pregunta.
- Un usuario restringido ve su propia restricción. “Alcance: Tienda — Maltepe Park.” La regla vive en el engine; sin una identidad resoluble se detiene en lugar de caer en “muéstralo todo”.
- Los datos personales se enmascaran mecánicamente. Una etiqueta de desglose se reduce a iniciales por regla, no por prompt.
- La ausencia se publica, no se traga. Un periodo sin datos se convierte en un data state cuya base es
empty_result_set: “no es un cero medido; no hay transacciones registradas en esta ventana”. Sin insignia de gravedad, con zona propia, y ninguna recommendation puede apoyarse en él.
Autoauditoría
“Cada cifra se verifica” es una afirmación. Por eso se pone a prueba cada semana.
Golden set
Un conjunto sellado de preguntas. Si dos ejecuciones devuelven la misma huella, el comportamiento no ha cambiado. Cuando cambia el modelo o el código, la diferencia aparece de inmediato.
Línea de tolerancia cero
Cifras sin fuente, negarse a estimar, enmascarado de datos personales. Alcanzar el umbral borrando cifras también se detecta.
Cadencia
Las pruebas se ejecutan automáticamente cada semana y en cada cierre de versión. Si una afirmación contradice la medición, el sistema se detiene solo.
Pantalla de servicios en vivo
Se mide en cada carga; nunca muestra un estado almacenado.
El modelo de confianza no da por supuesto que los errores vayan a caer a medida que mejoren los modelos. Aunque cambie el modelo, el direccionamiento, el registro de auditoría, la cadena de publicación y las comprobaciones de autoridad siguen siendo deterministas.